适应度预测模型
在同一套 138 维特征(one-hot 80 + 理化描述符 28 + 位点对交互 30)上训练五个 baseline, 按验证集 Spearman 选优。核心挑战是外推:模型只见过 ≤2 点突变,却要给 3–4 点组合排序。
测试集 Spearman ρ
0
对 147,193 个未知高阶组合排序
测试集 Pearson r
0
log 空间的线性相关性
测试集 MSE
0
log10(fitness + 0.01) 空间
验证集 Spearman ρ
0
低阶变体的留出验证表现
五个 baseline 的对比
验证集(内插)与测试集(外推)之间的落差,就是这个任务的真实难度
Spearman 相关系数
内插 vs 外推
Top-k 命中率(测试集)
预测 Top-k 中有多少确实属于真实 Top-k
完整指标表
按验证集 Spearman 降序排列,第一行为最终选用的模型
| 模型 | 验证 ρ | 验证 MSE | 测试 ρ | 测试 r | 测试 MSE | 测试 MAE | 测试 R² | recall@10 | recall@100 | NDCG@100 |
|---|---|---|---|---|---|---|---|---|---|---|
| XGBoost 梯度提升树 选用 | 0.9025 | 0.0470 | 0.4893 | 0.7047 | 0.1552 | 0.2871 | 0.2889 | 0.000 | 0.190 | 0.927 |
| 极端随机树 | 0.8971 | 0.0523 | 0.4625 | 0.7220 | 0.1257 | 0.2528 | 0.4244 | 0.000 | 0.150 | 0.906 |
| 随机森林 | 0.8911 | 0.0653 | 0.4562 | 0.6439 | 0.1633 | 0.2962 | 0.2522 | 0.000 | 0.030 | 0.889 |
| 多层感知机 MLP | 0.8579 | 0.0940 | 0.4586 | 0.6292 | 0.2460 | 0.3937 | -0.1266 | 0.000 | 0.110 | 0.898 |
| Ridge 线性回归 | 0.8505 | 0.1491 | 0.4720 | 0.5247 | 0.6482 | 0.6276 | -1.9690 | 0.000 | 0.020 | 0.869 |
📌
所有模型都呈现同一个规律:验证集 ρ ≈ 0.9,测试集 ρ ≈ 0.5。
训练集主要包含单点和双点突变,测试集包含三点和四点突变,存在分布差异和高阶相互作用。
训练集最大值并非所有回归模型的预测上限。高适应度区域的误差说明需要评估探索策略,
但仅凭预测误差不能证明 Agent 优于模型直接推荐。
可视化诊断
预测质量、能力边界与特征重要性
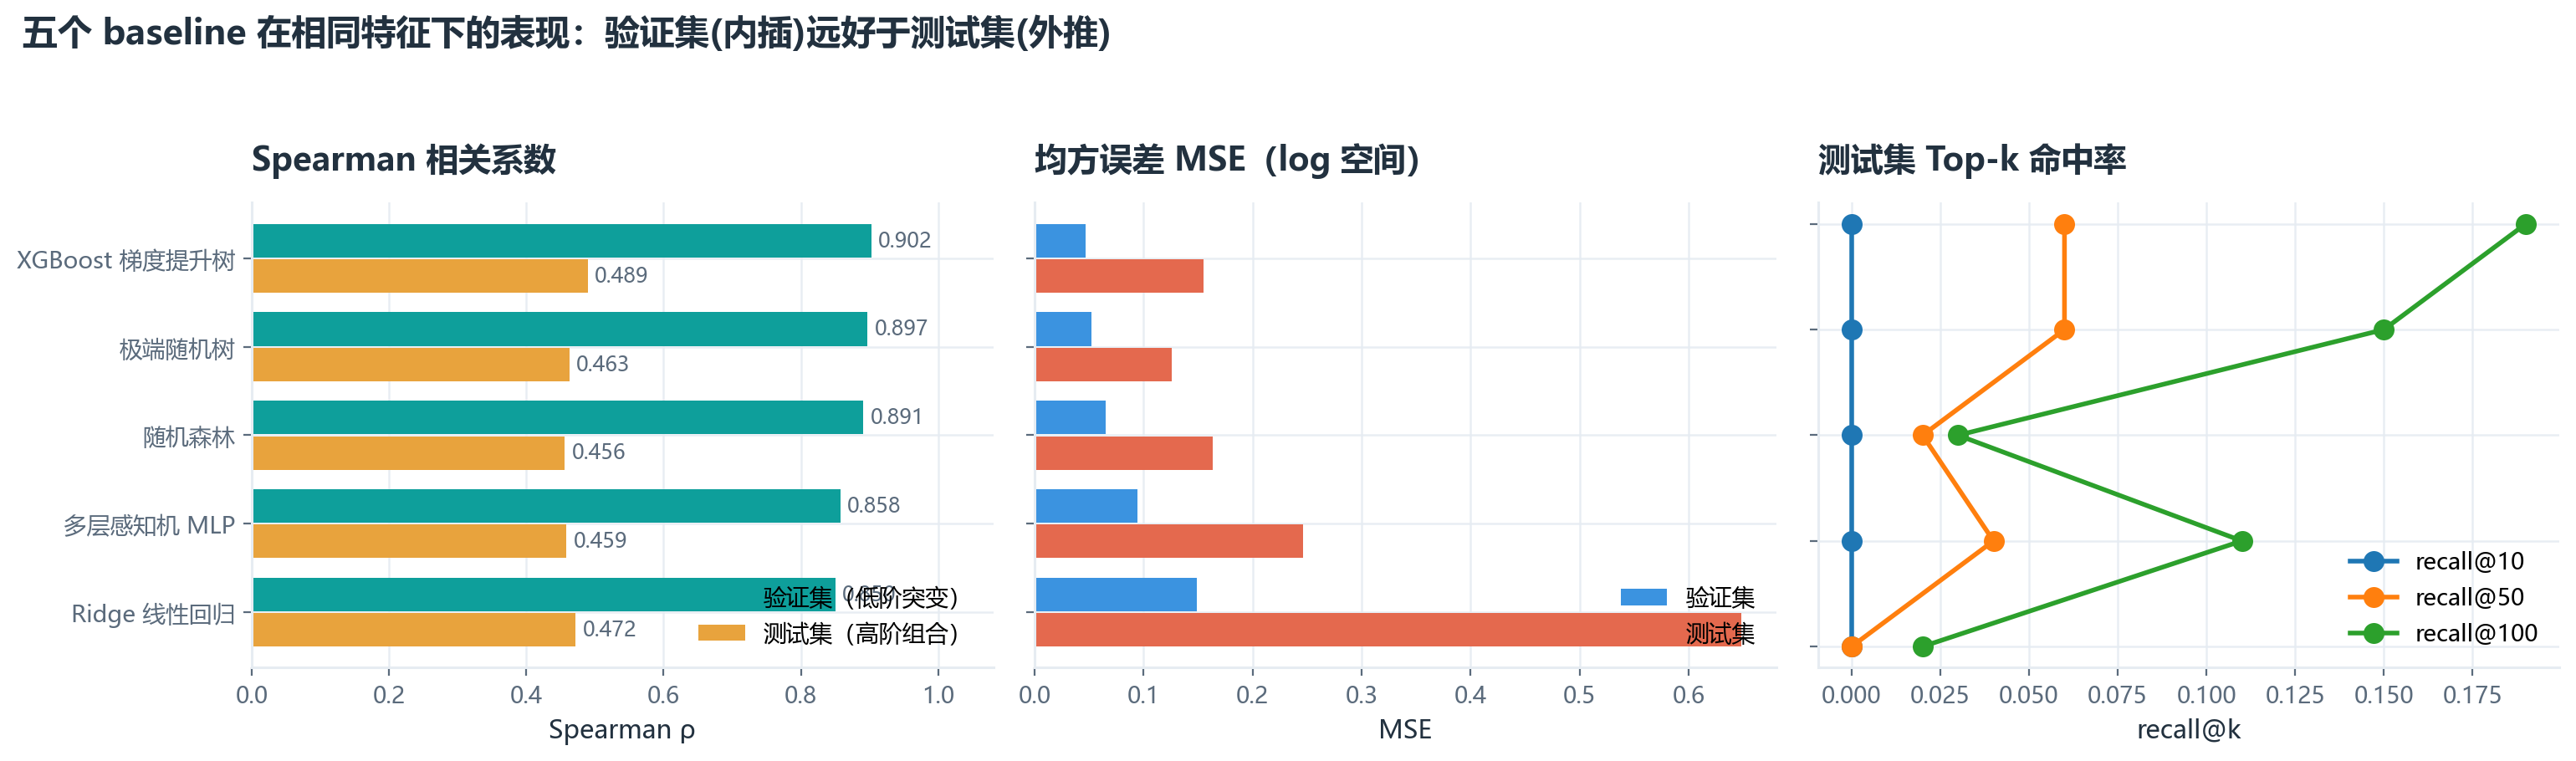
模型对比
五个 baseline 的 Spearman / MSE / Top-k 命中率
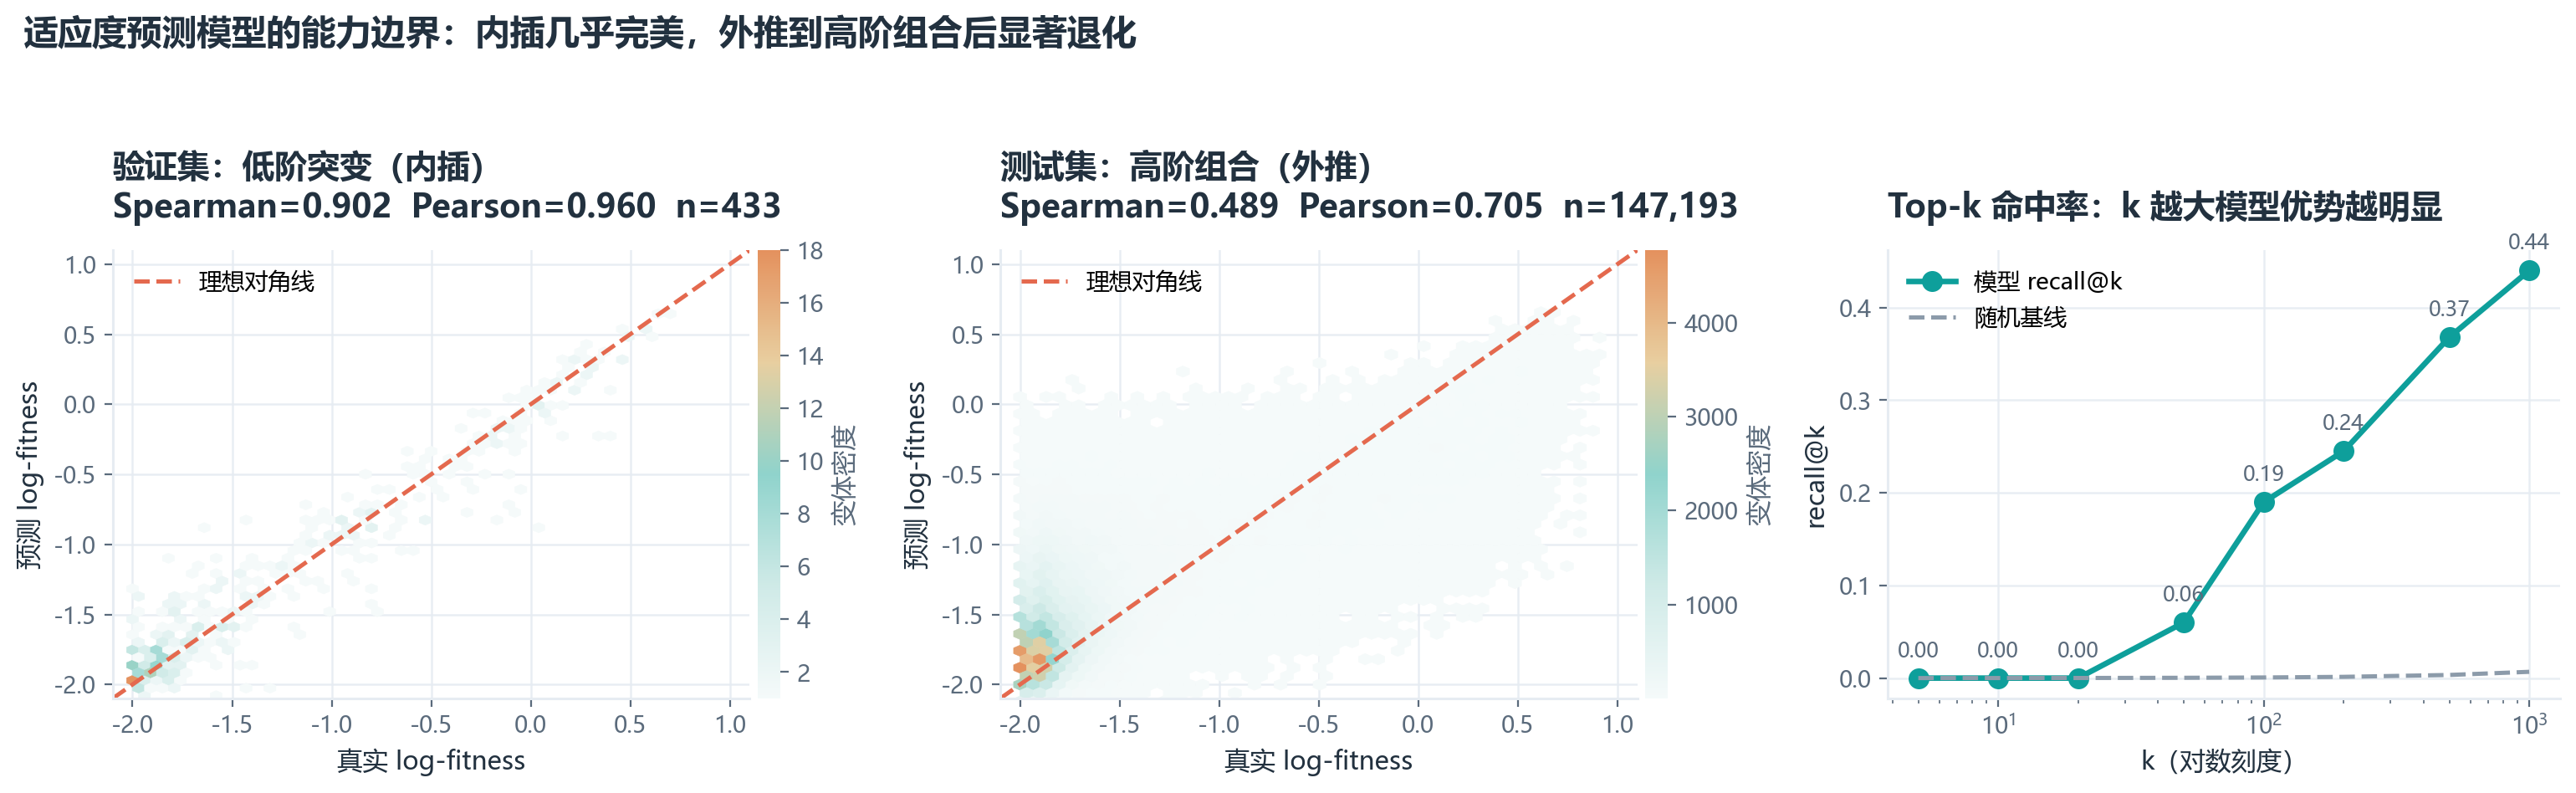
预测质量
内插与外推的散点密度图及 Top-k 命中率曲线
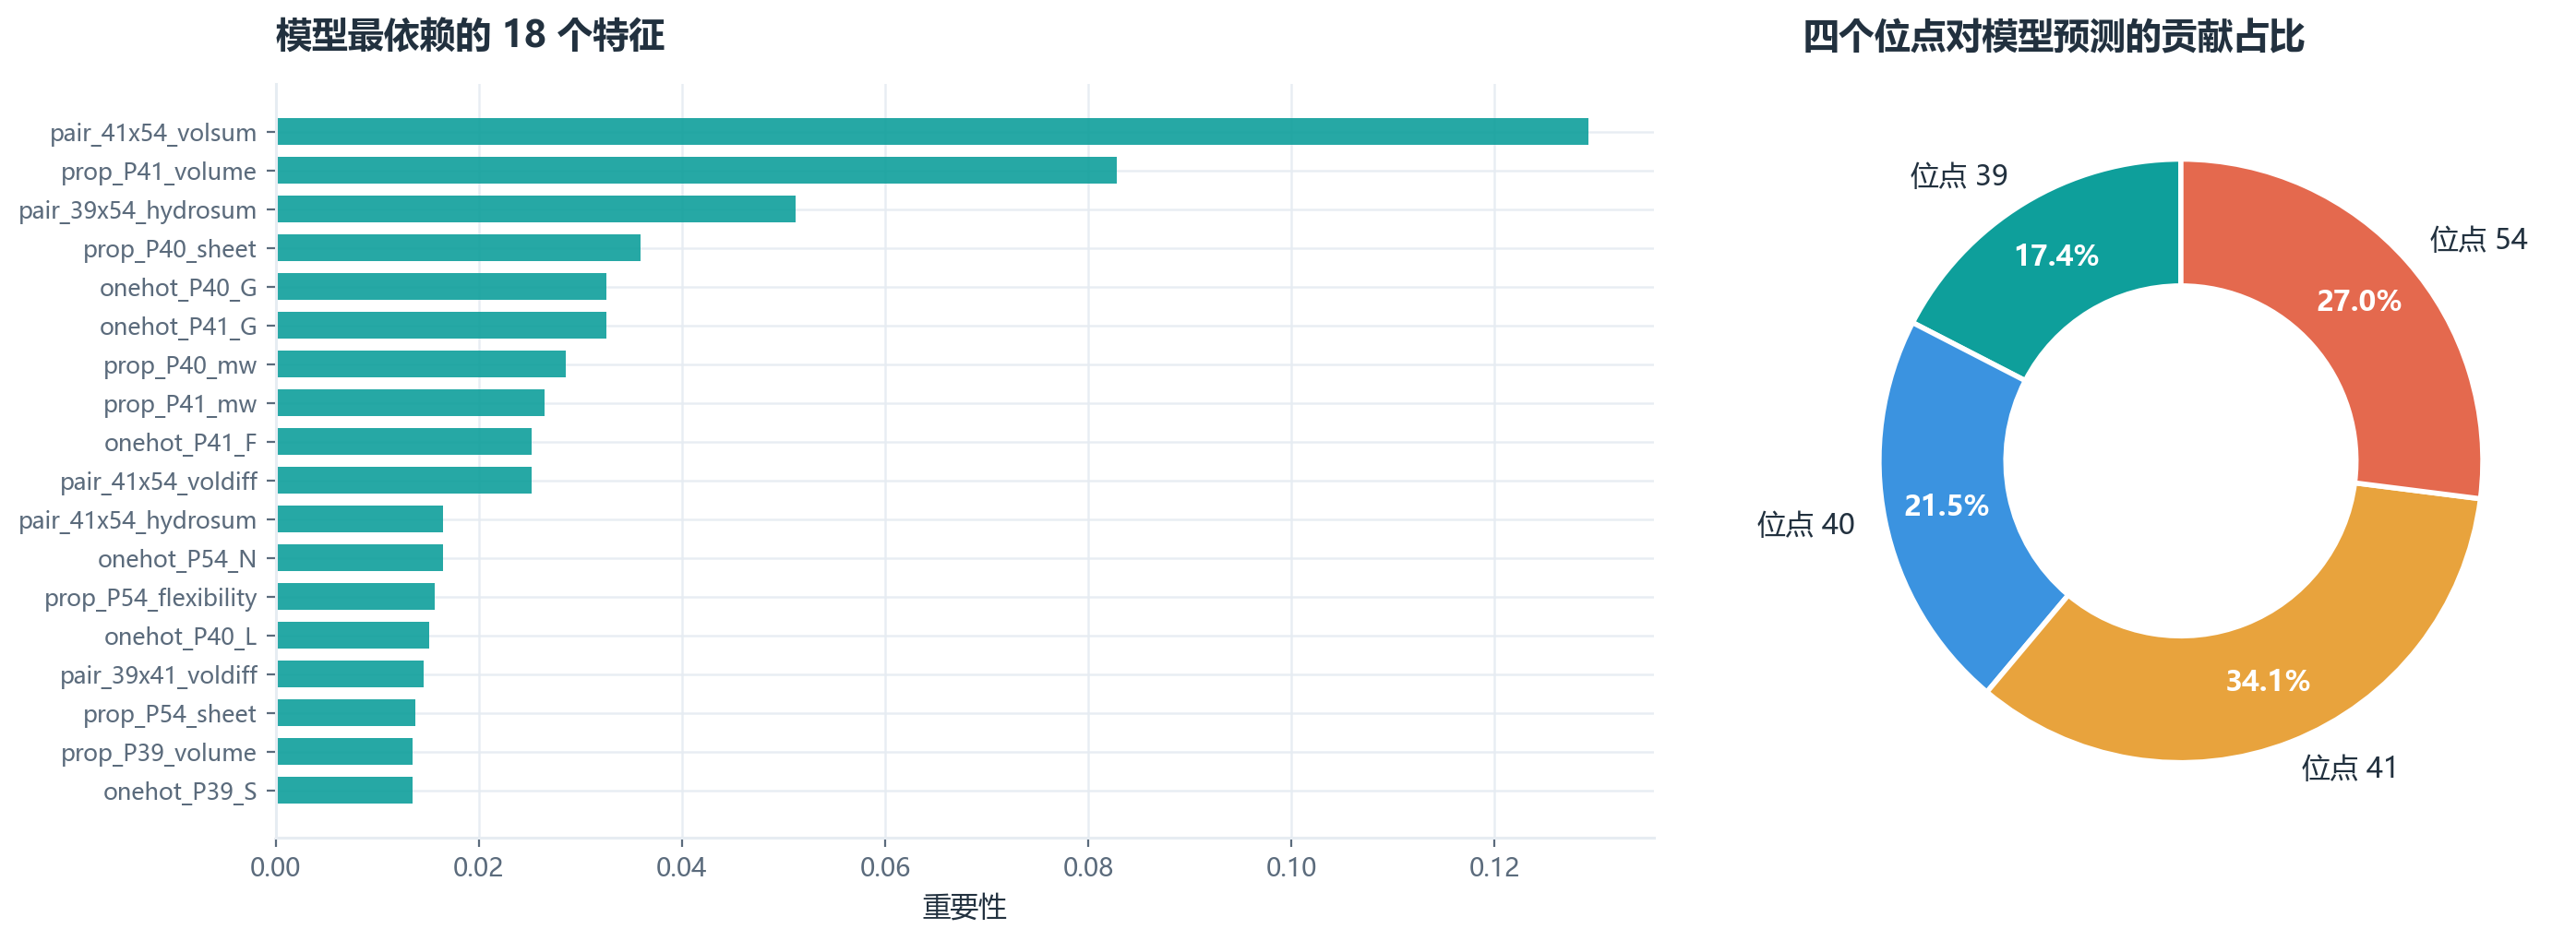
特征重要性
模型最依赖的特征与四个位点的贡献占比
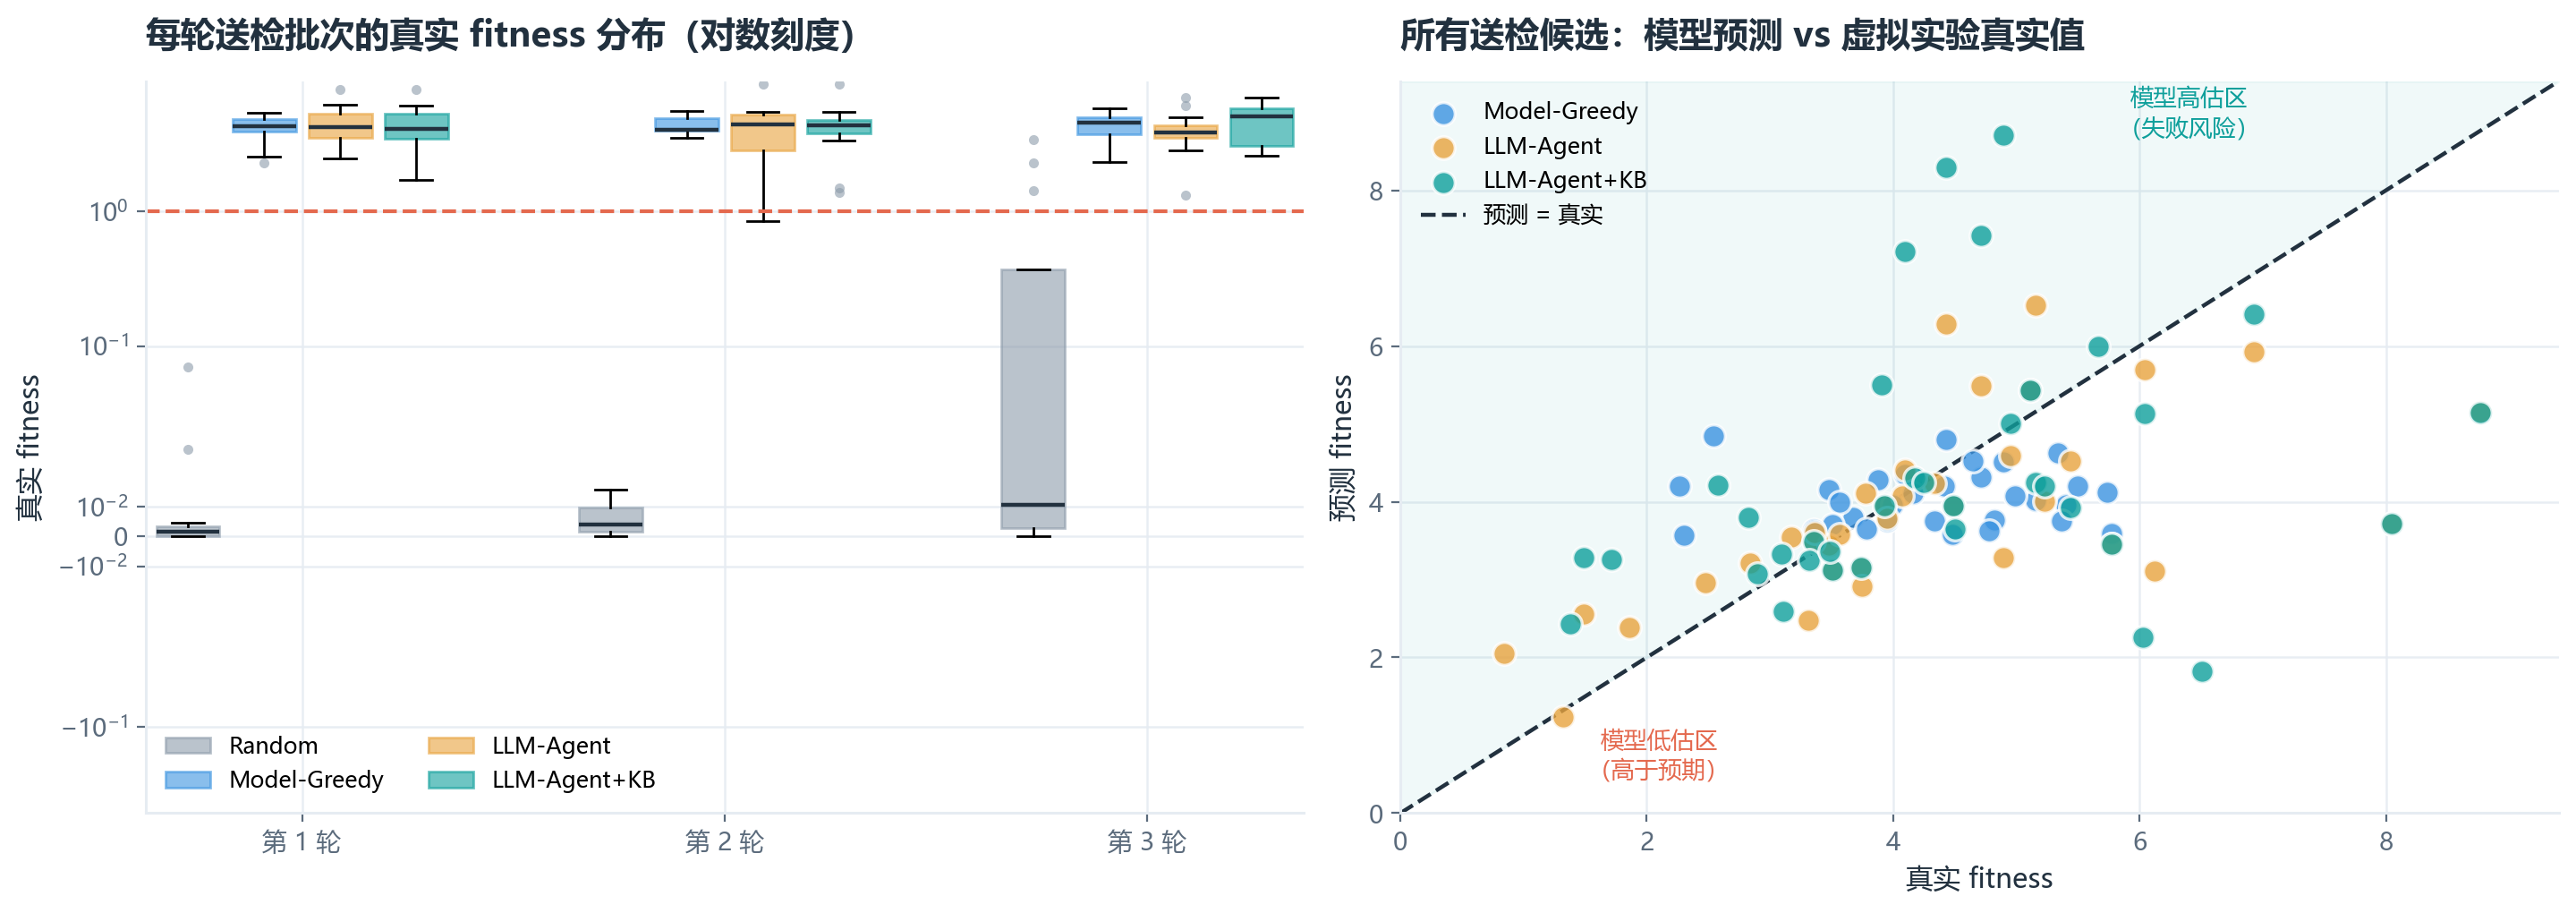
批次预测误差
所有送检候选的预测值与虚拟实验真实值对照